01 · 规则
完整 HUNL 状态模型
52 张牌、四个下注轮次、盲注、终局收益、牌型评估,以及弃牌到全押的动作抽象。
一套由公开源码验证的研究框架:CFR 子博弈求解、ReBeL 风格递归求解、反事实价值学习、自博弈与 C++ 蒙特卡洛组件。
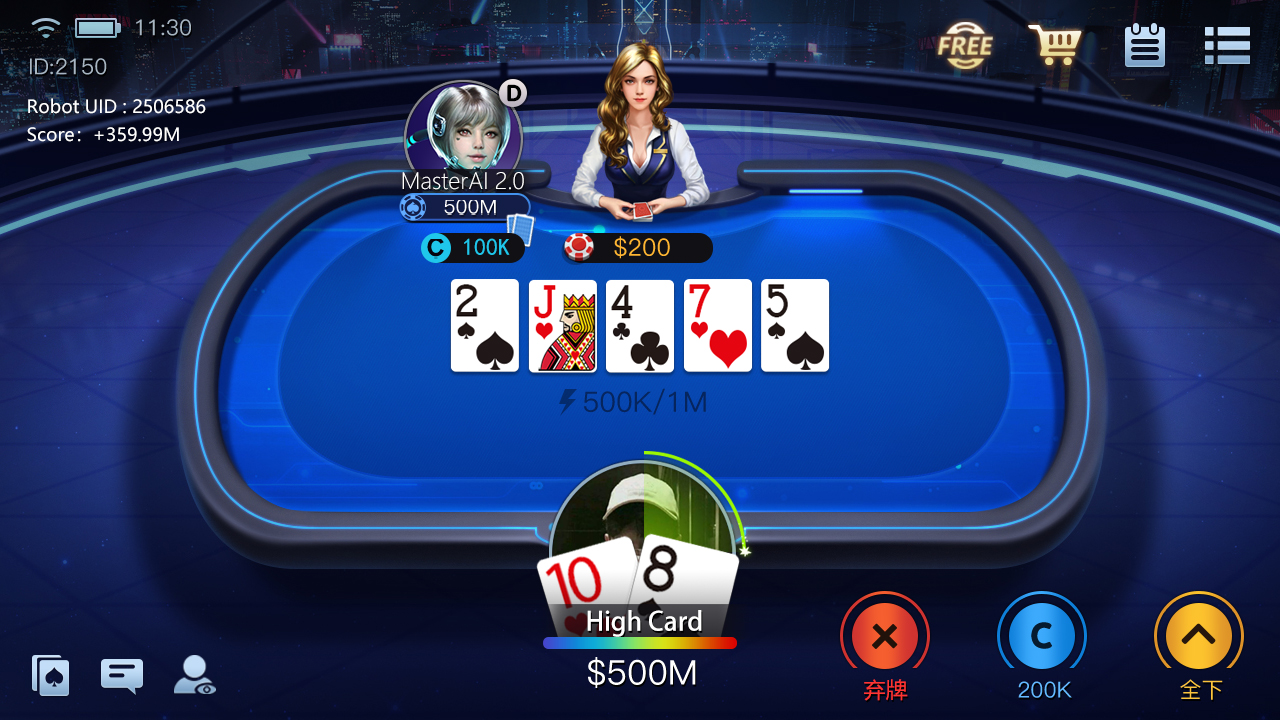
所有功能都能映射到仓库模块;页面不再使用无法证明的识别率、响应速度、盈利提升、平台适配或一键安装宣传。
52 张牌、四个下注轮次、盲注、终局收益、牌型评估,以及弃牌到全押的动作抽象。
遗憾更新、平均策略、到达概率、最佳响应、期望收益与可利用度相关工具。
从公共状态展开子博弈,按行动更新双方私牌信念,并在后续状态继续求解。
使用 PyTorch 对截断叶节点估值,支持价值与策略学习实验。
多进程样本生成、模型同步、回放缓冲、训练批次和验证流程。
原生模拟器、Python 牌型工具与绑定基础设施,补充 Python 算法层。
引擎覆盖翻牌前、翻牌、转牌和河牌。公共状态记录公共牌、累计下注、当前行动者、可行行动与加注次数。
游戏引擎生成合法行动、后继状态、终局与手牌收益。
迭代更新即时遗憾和平均策略,配置后可用价值网络估计叶节点。
反事实价值与策略样本经回放系统进入 PyTorch 模型。
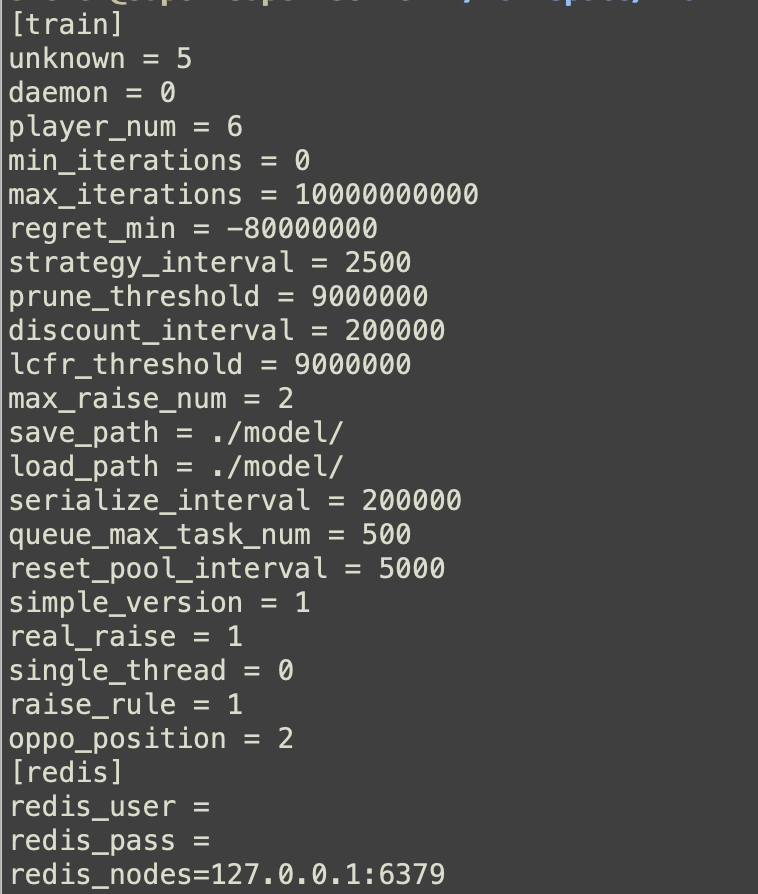
这张图展示训练迭代、遗憾设置、剪枝、模型路径和 Redis 连接。它是训练配置/终端画面,不是线上牌桌识别界面。
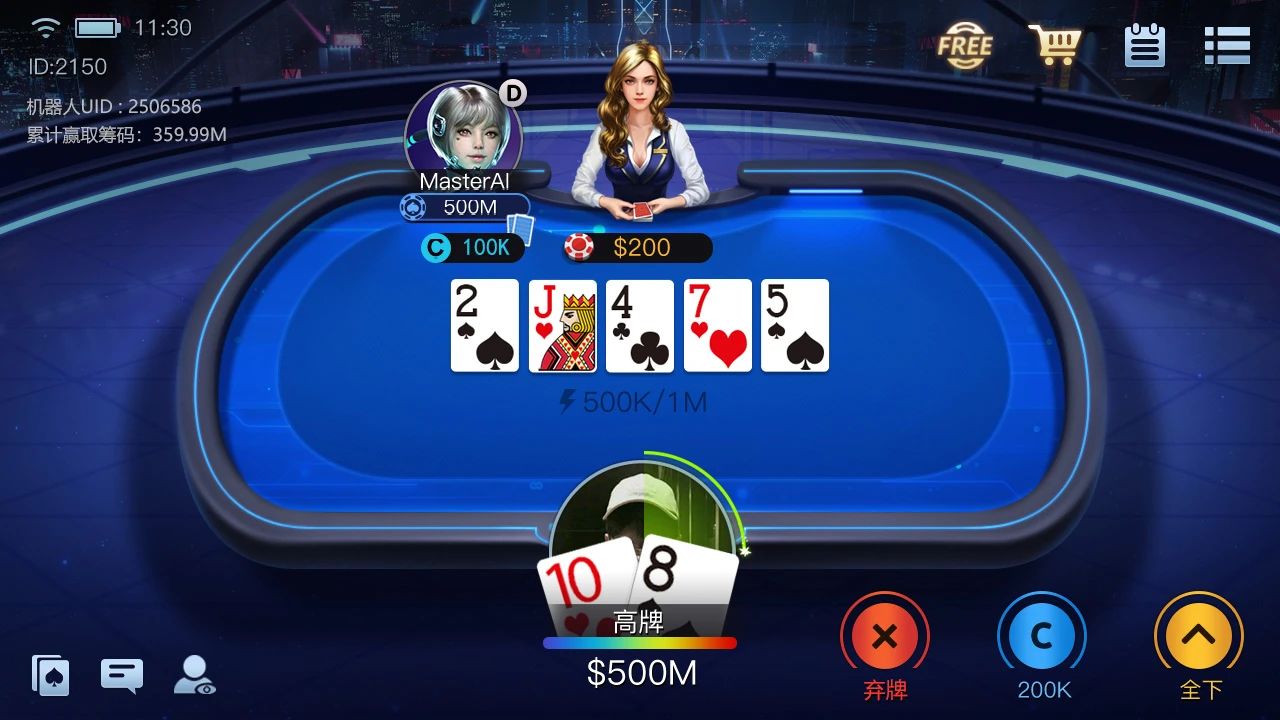
图片展示机器人席位与牌桌呈现,但不能证明 OCR、自动操作或第三方平台集成,因此页面不会作出这些声明。
用于合法研究、教育、离线训练与基准测试。请勿用于未经允许的线上实时决策、自动操作、规避平台规则或破坏公平性的行为。